実験
実験#02:AIが作って、遊んで、直したゲームは面白くなるのか
AIがゲームを作り、ボットに何百回も遊ばせ、数字を見て直した。最終版は数値目標をすべて満たしたのに、人間がどちらか知らずに遊ぶと、最初の版のほうが面白いという評価だった。
結論
最終版 v3 は、AIが事前に決めた3つの数値目標をすべて満たした。しかし人間(1人)がどちらか知らずに遊ぶと、評価は最初の v1 が 2、v3 が 1 だった。判定は「一部確認(人間評価では失敗条件に該当)」。今回のゲーム・今回の指標・評価者1人という条件では、数字の改善と人間の面白さの評価は一致しなかった
先に結論
AIの数字では良くなった。でも人間が遊んだら、最初のほうが面白かった。
最終版の v3 は、AIが事前に決めた3つの数値目標をすべて満たしました。ところが、人間がどちらの版か知らないまま遊ぶと、評価は最初の v1 が 2、v3 が 1(5段階)。判定は 「一部確認(人間評価では失敗条件に該当)」 です。
ただし、評価したのは1人だけです。言えるのは「今回のゲーム・今回の指標・評価者1人という条件では、一致しなかった」ということまでです。
どんな実験だったか
この実験は、テーマからAIが考えました。人間が決めたのは「この企画でやる(GO)」ということと、途中の判断だけです。
AIはゲームを作れます。では、作ったゲームが面白いかどうかを、AIが自分で判断して直せるのか。作る・遊ぶ・直すを全部AIに任せたらどうなるのかを試しました。
流れはこうです。
- AIが「面白さの数値目標」を決めて、ゲームを作る前に固定する
- AIがゲームを作る
- ボット(自動で遊ぶプログラム)に何百回も遊ばせて、数字を取る
- 数字を見て、AIが直す(版は最大 v3 まで)
- 最後に、人間が最初の版と最後の版を、どちらか分からないまま遊んで評価する
AIが作った「さかさまラン」
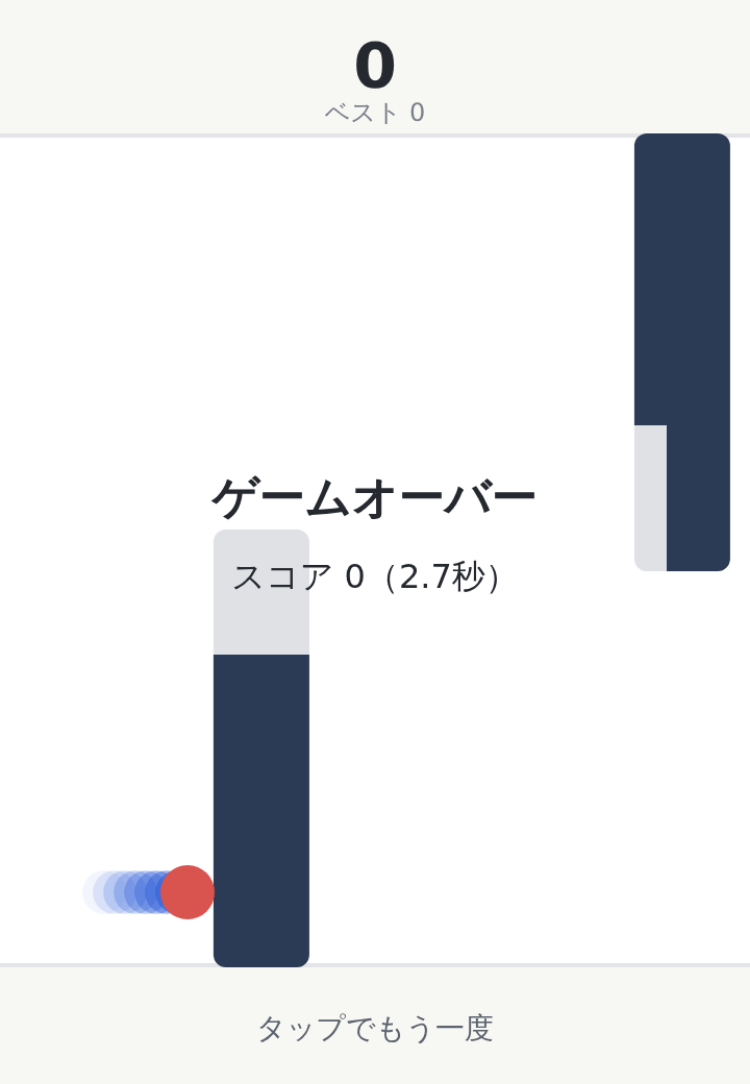
AIが考えたゲームは「さかさまラン」です。タップするたびに、ボールが天井と床を行き来します。上か下から壁が来るので、反対側によけて進みます。進むほど速くなり、よけた壁の数がスコアです。
AIが決めた数値目標
ゲームを作る前に、AIは「面白いゲーム」を次の3つの数字で表すことにしました。あとから都合よく変えられないように、この目標はゲームのコードを書く前に commit(記録)して、GitHub に送っています。
| 目標 | ねらい | |
|---|---|---|
| M1 | 考えて押すボットのプレイ時間の中央値が 20〜60秒 | 1回がちょうどよい長さ |
| M2 | 5秒未満で終わるプレイが 10%以下 | すぐ終わって嫌にならない |
| M3 | 考えて押すボットの平均スコアが、でたらめに押すボットの2倍以上 | 運だけでなく腕の差が出る |
AIに200回ずつ遊ばせた
ボットは2種類です。でたらめに押すボットと、画面の様子を見て押すボット(見てから反応するまで 0.15〜0.35秒かかる)。1つの版につき、それぞれ200回遊ばせました。
最初の v1 の結果は、考えて押すボットのプレイ時間の中央値が 5.2秒。43% のプレイが5秒もたずに終わりました。AIは「最初から難しすぎる」と分析し、壁の間隔を広げ、はじめの速さを落とした v2 を作りました。
「v2 なら中央値 20〜40秒くらい」とAIは予想しました。ところが結果は 8.6秒。予想から大きく外れました。
ボットの不具合が発覚
予想が外れた理由を調べると、悪かったのはゲームではなく、ボットのほうでした。
考えて押すボットは、タップしたあと、自分がタップする前の古い画面を見てしまうことがありました。そして「まだ壁の側にいる」と思って、もう一度タップします。せっかくの切りかえを、自分で取り消していたのです。
- 考えて押すボットのタップの約32% が、この「取り消し」だった
- v2 で死んだ200回のうち192回が、取り消しの1秒以内だった
つまりAIは、自分で作った壊れた物差しの数字を信じて、ゲームを直していたことになります。ここでAIは作業を止め、続け方を人間に判断してもらいました。
物差しを直して測り直した
人間の判断は「ボットの不具合だけを直して、v1 と v2 を同じ条件で測り直す」。直したのは「自分の最後のタップより前の画面では判断しない」という1か所だけです。もとのボットと、もとのボットでの結果は消さずに残しています。
測り直すと、話がひっくり返りました。
| 考えて押すボット | v1(旧) | v1(直したボット) | v2(旧) | v2(直したボット) |
|---|---|---|---|---|
| プレイ時間の中央値 | 5.2秒 | 21.2秒 | 8.6秒 | 78.8秒 |
| 5秒未満で終わった割合 | 43% | 0% | 22% | 0% |
最初の v1 は、正しく測れば目標をすべて満たしていました。 一方、壊れた物差しに合わせて直した v2 は、やさしすぎる(中央値 78.8秒)方向に行き過ぎていました。
なお、決めておいた手順には「目標をすべて満たしたら改良をやめる」とありました。この手順どおりなら v2 は作らなかったことになります。この食い違いも記録に残しています。
AIが v3 に改良した
v2 は、約34秒で速さが上限に届き、そこから難しさが上がらなくなっていました。そこでAIは、2か所だけを変えた v3 を作りました。
- 1秒ごとに速くなる量:8 → 10
- いちばん速いとき:420 → 560
測る前に「中央値は 30〜45秒くらい」と予想を記録し、実際は 37.9秒 でした。5秒未満は 0%、スコアはでたらめなボットの約87倍。3つの目標をすべて満たしました。
人間にA/Bテストしてもらった
最後は人間の番です。比べたのは、AIが最初に作った v1 と、数字をもとに直した最終版 v3 です。
どちらを A・B にするかはAIが乱数で決め、その中身は伏せたまま、ハッシュ値(中身を確かめるための値)だけを評価の前に commit しました。評価した人は対応表を見ないまま、スマートフォンで A・B を3回ずつ遊び、5段階で評価しました(どちらも人の報告)。
A:1 B:2(人の報告)
評価を記録してから対応表を開くと、A が v3、B が v1 でした。開いた中身のハッシュ値は、評価の前に記録した値と一致しています。
数字と人間の評価が一致しなかった
| AIの数字(直したボット) | 人間の評価(5段階) | |
|---|---|---|
| v1(最初の版) | 中央値 21.2秒・目標をすべて満たす | 2 |
| v3(最終版) | 中央値 37.9秒・目標をすべて満たす | 1 |
AIの数字の上では、v3 は目標の範囲の真ん中に近づき、狙いどおりに直せていました。それでも人間は、最初の v1 のほうを高く評価しました。
成功条件は4つありました。1〜3(スマホで遊べる・各版200回の記録・最終版が数値目標を満たす)は満たし、4(人間が最後の版を最初の版より面白いと評価する)は満たしませんでした。企画書には「人間が最初の版のほうを面白いと評価する」が失敗条件として書いてあり、今回はそれに当たります。なので判定は「一部確認(人間評価では失敗条件に該当)」です。
今回分かったこと
- AIは、ゲームを作れた
- AIは、ボットを使って何百回もの自動測定ができた
- AIは、数値目標を決め、それに合わせてゲームを直せた。最終版 v3 は目標をすべて満たした
- 物差し(ボット)が壊れていると、AIはその数字を信じて、逆方向に直してしまうことがある
- 正しく測ると、最初の v1 も目標を満たしていた
今回分からなかったこと
- AIが決めた数字の改善が、人間にとっての「面白さ」の改善につながるか。今回の条件では一致しなかった
- 評価する人を増やしても、同じ結果になるか(今回は1人)
- 人間が v1・v3 とも低く評価した理由(感想の記録はない)
- 遊ぶ順番の影響(「A を3回、続けて B を3回」と案内したが、実際の順番は記録していない)
この結果から「AIの数字は人間の役に立たない」とまでは言えません。言えるのは、今回のゲーム・今回の指標・評価者1人という条件では一致しなかった、ということです。
次の実験につながる問い
- 人間が「面白い」と感じるとき、数字では何が起きているのか。プレイ時間や腕の差のほかに、見るべき数字はあるか
- 評価する人を増やしたら、v1 と v3 の差はどうなるか
- 物差しを作ったAI自身が、その物差しの不具合に早く気づくには、どうすればいいか
くわしい手順・数字・証拠は、実験#02 の記録ページの「詳細な実験記録」にすべて残しています。
まとめ
AIに「作る・遊ぶ・直す」を任せると、数字の上ではちゃんと良くなりました。でも人間が遊んだら、最初の版のほうが面白かった。そして途中では、AIが自分で作った物差しに自分でだまされていました。うまくいったことも、いかなかったことも含めて、この実験室らしい結果になりました。
証拠(実際の画面・記録)
画像をタップすると、元の大きさで開きます。
さかさまラン v1 の画面(AIの作業環境のブラウザで撮影)。タップしないと、最初の壁に当たってゲームオーバー - ゲームを作る前に固定した数値目標と決まり(commit f82df51)
- 修正版のボットによる v1 の結果(各200回)
- 修正版のボットによる v3 の結果(各200回)
- もとのボット(不具合あり)による v1 の旧結果(削除せずに残している)
- もとのボット(不具合あり)による v2 の旧結果
- 修正版のボットによる v2 の再測定
- 人間のブラインド評価の結果(人の報告)
- A/B の対応表の開示と、評価前に固定した値との一致の確認
- AIの作業記録(各段階の結果・分析・ボットの不具合・食い違い)
この記事について
- 確かめたこと
- AIが自分で作ったゲームを、ボットに何百回も遊ばせて数字で直したら、人間にとっても面白くなるのか
- 試した日
- 2026年10月3日
- 環境
- Claude Code(クラウド上の作業環境) / Chromium(Playwright)でボットを実行 / 人の評価:スマートフォン
- 費用
- 追加の有料サービスは使っていない(Claude Code の利用料金は不明)
- 使ったAI
- Claude Code(Anthropic)
- AIの役割
- 実験の企画、数値目標の設定、ゲームとボットの制作、測定と改良、記録と記事の下書き
- 人の確認
- 確認済み(2026年10月3日)