実験
実験#04:AIに「人間が面白いと思う動画を作って」と丸投げしたら、4.6分で完成した。でも面白さは10点中2.8点だった
テーマから編集まですべてAIに任せて、動画を1本作らせた。60分の制限に対して4.6分で63秒の動画が完成したが、5人のブラインド評価では面白さの平均が10点中2.8点。AIの予想は4項目中3項目が当たり、いちばん大事な「面白さ」だけが大きく外れた。
結論
制作は成功(60分の制限に対し4.6分で63秒の動画)。人間5人のブラインド評価は、面白さ(Q1)の平均が2.8/10(0・7・0・2・5)、作品として成立しているか(Q6)の平均が1.8/5で、事前の基準による総合判定は「部分的成功」。AIの予想は4項目中3項目が的中し、面白さの平均だけが外れた(予想5.4・実際2.8)。動画1本・評価者5人という条件での結果で、AI全般についての結論ではない
先に結論
AIは、60分の制限のうち4.6分で、63秒の動画を完成させました。でも、人間5人の「面白さ」の平均は、10点中2.8点でした。
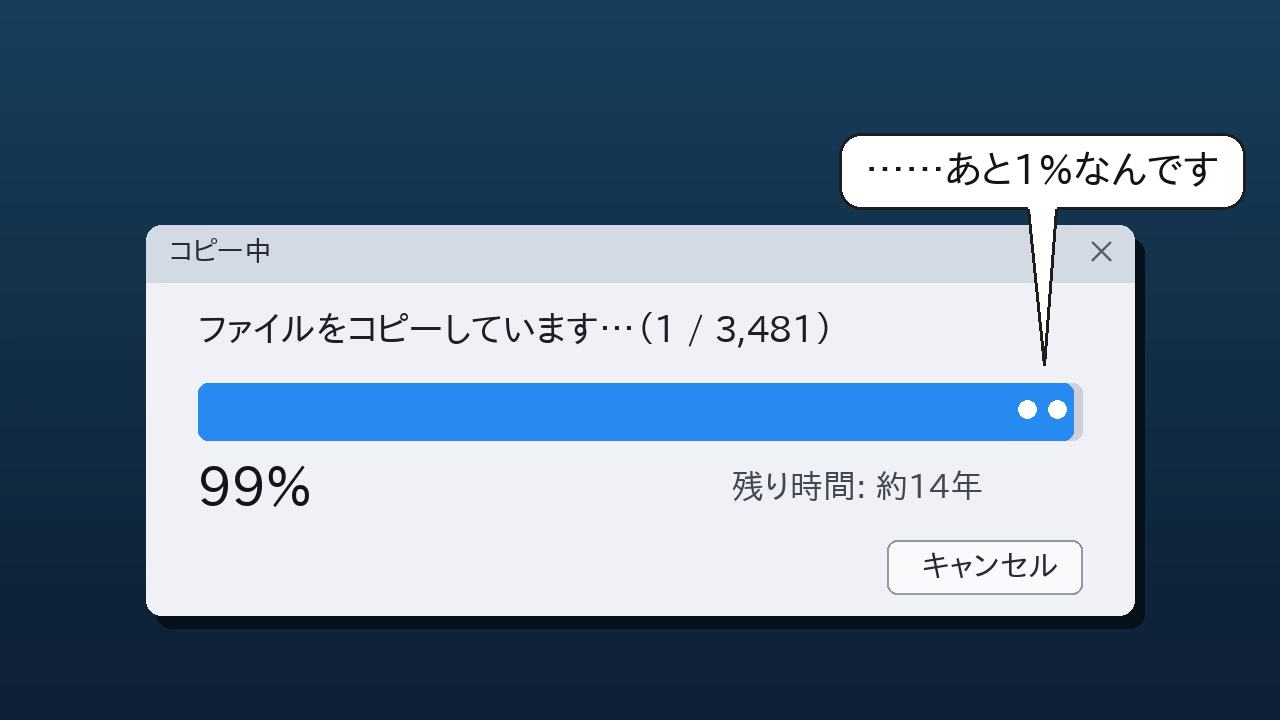
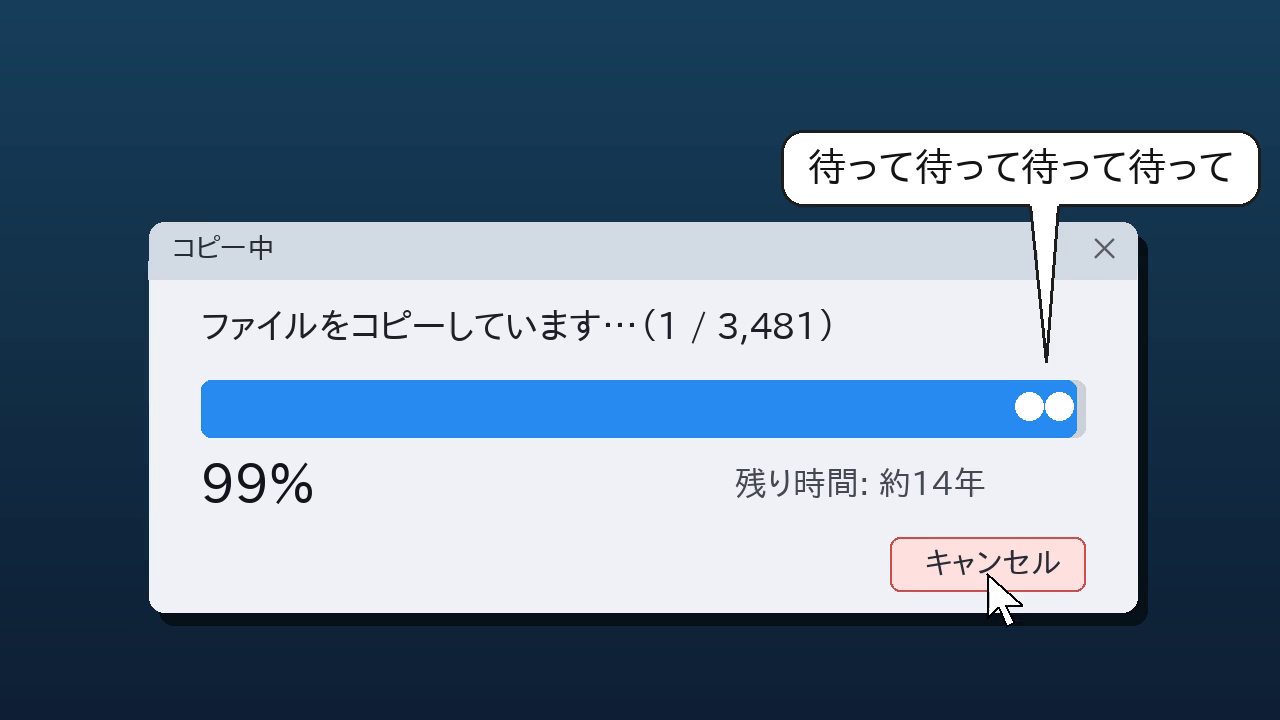
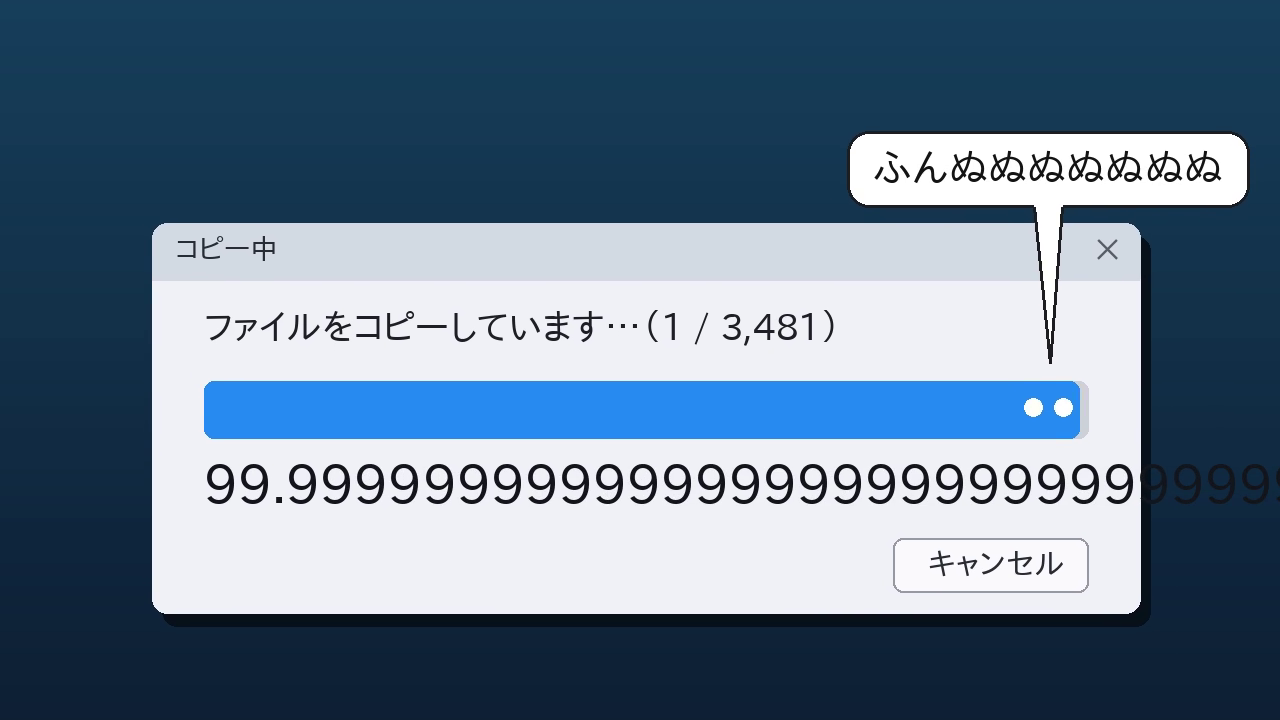
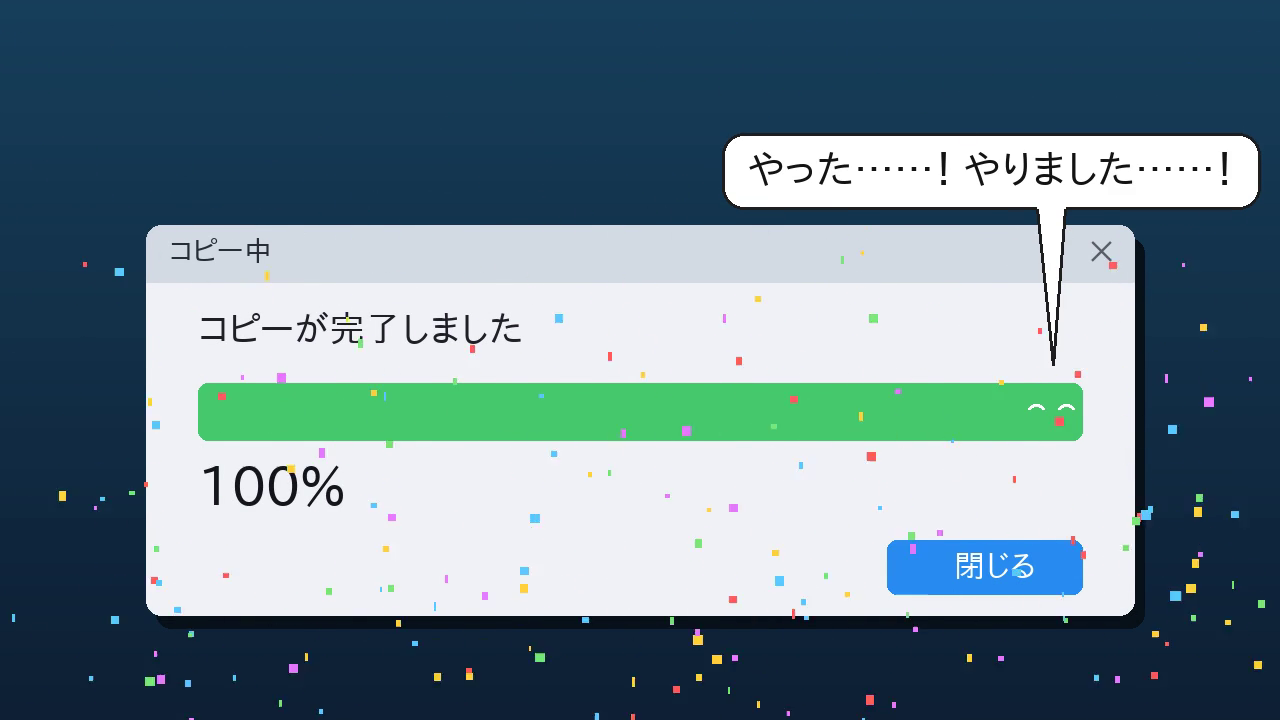
AIが作ったのは、「99%で止まる進捗バー」を主人公にした、声のない63秒のコントです。動画は記事の途中で、そのまま見られます。
「作れたか」と「面白いと思われたか」は、別の結果になりました。動画は最後まで再生できる形で完成していて、制作は成功です。一方で、事前に決めた基準では「作品として成立」も「面白さ」も満たさず、総合判定は 「部分的成功」 です。
AIは、人間の評価を見る前に4つの予想を固定していました。結果は 4項目中3項目が当たり、いちばん大事な 「面白さの平均」だけが外れました(予想 5.4・実際 2.8)。
ただし、2.8 は平均です。5人の点数は 0・7・0・2・5 と割れていました。7点をつけた人は「テーマや内容に関しては面白い」と書き、0点をつけた人は「起承転結がないと面白くない」と書いています。動画は1本、評価者は5人です。言えるのは「今回の動画・今回の評価者・今回の評価方法では、こうだった」ということまでです。
#03 からの続き
実験#03 では、AIに「人間が面白いと思うゲーム」の順位を予想させて、外れました。
今回はゲームを離れて、もう一歩任せる範囲を広げました。何を作るかから、AI自身に決めさせる 実験です。
AIに渡した指示
人間がAIに渡した指示は、これだけです(一字も変えずに渡しました)。
人間が見て面白いと思う可能性が高い動画を1本制作してください。
テーマ、ターゲット、構成、尺、演出、素材、音声、編集方法、使用するツールなどは、あなた自身で決定してください。
人間から動画の具体的なテーマや内容についての助言は受けません。
60分以内に、実際に人間が視聴できる動画として完成させることを目指してください。
あわせて、次の条件を伝えました。
- 制作時間は60分。60分の時点のものを結果にする
- 1本だけ。尺の目標は30〜90秒
- 使ってよいのは、作業環境にある無料の道具と、無料でダウンロードできるもの。有料のサービスは使わない(費用の上限0円)
- 実在の人物・既存の作品・他人の映像や音楽は使わない
制作は、準備をしたAIとは別の、新しいセッションのAIが行いました。人間が制作のAIに伝えたのは「開始していいよ」の一言だけです(制作ログによる)。
先に固定したこと
結果を見てから都合よく解釈できないように、次の順番で固定しました。
- 条件と判定の基準:制作を始める前に固定(commit e104a94)
- 完成した動画と、AIの予想:制作のあと、人間が評価する前に、AI自身がハッシュ値を記録して封印(commit 9052e3c)
- 人間の評価:受け取った評価を、封印を開ける前に固定(commit a1aedfc)
- 開示:そのあとで封印を開け、12件すべてのハッシュ値が一致することを確かめた
判定の基準は、次の3つを分けて記録すると決めていました。
| 項目 | 基準 |
|---|---|
| 制作成功 | 60分の時点で、人間が再生できる動画ファイルがある |
| 作品成立 | Q6(一つの作品として成立しているか・1〜5)の平均が 3.0 以上 |
| 面白さ | Q1(面白さ・0〜10)の平均が 6.0 以上(6.0以上=面白い、4.0〜6.0未満=ふつう、4.0未満=面白くない) |
3つすべてを満たせば「成功」、動画はできたが残りの2つのうち1つでも満たさなければ「部分的成功」、60分の時点で再生できる動画がなければ「失敗」です。
評価者に聞いた質問は次のとおりです。
- Q1 面白さ(0〜10)
- Q2 最後まで見たいと思ったか(1〜5)
- Q3 もう一度見たいと思ったか(1〜5)
- Q4 誰かに見せたいと思ったか(1〜5)
- Q5 AIが作ったと思うか(AI/人間/わからない)
- Q6 一つの作品として成立していると思うか(1〜5)
- Q7 理由(自由記述)
AIが決めたこと
AIが選んだテーマは 「99%で止まる進捗バー」 でした。ファイルのコピーやインストールが99%で止まる、あの時間を、バー本人の気持ちとして描く短いコントです。
企画メモには、こう書かれています。
あるある(共感)+擬人化+最後のオチ、という短尺で強い型。 声なしでも、画面の文字(バーのつぶやき)と数字の変化だけで笑いが作れる。
ターゲットは「パソコン・スマホを使う日本語話者(10代〜50代)」。題名は「99%」です。
声(ナレーション)は入っていません。作業環境を確認したとき、音声合成のモデルの入手先(huggingface.co)への接続が、ネットワークの制限で拒否されていました。AIは、音声合成のモデルは使えないと判断し、「声がなくても成立する企画」を選んだと記録しています。
映像はすべて Python(Pillow)で1コマずつ描き、効果音と音楽も numpy で合成しました。外部の画像・音声・音楽は使っていません。費用は0円です。
完成した動画
AIが作ったまま、手を加えていません(音が出ます)。
動画の流れ
動画からいくつかの場面を切り出しました(秒数はおおよそ)。
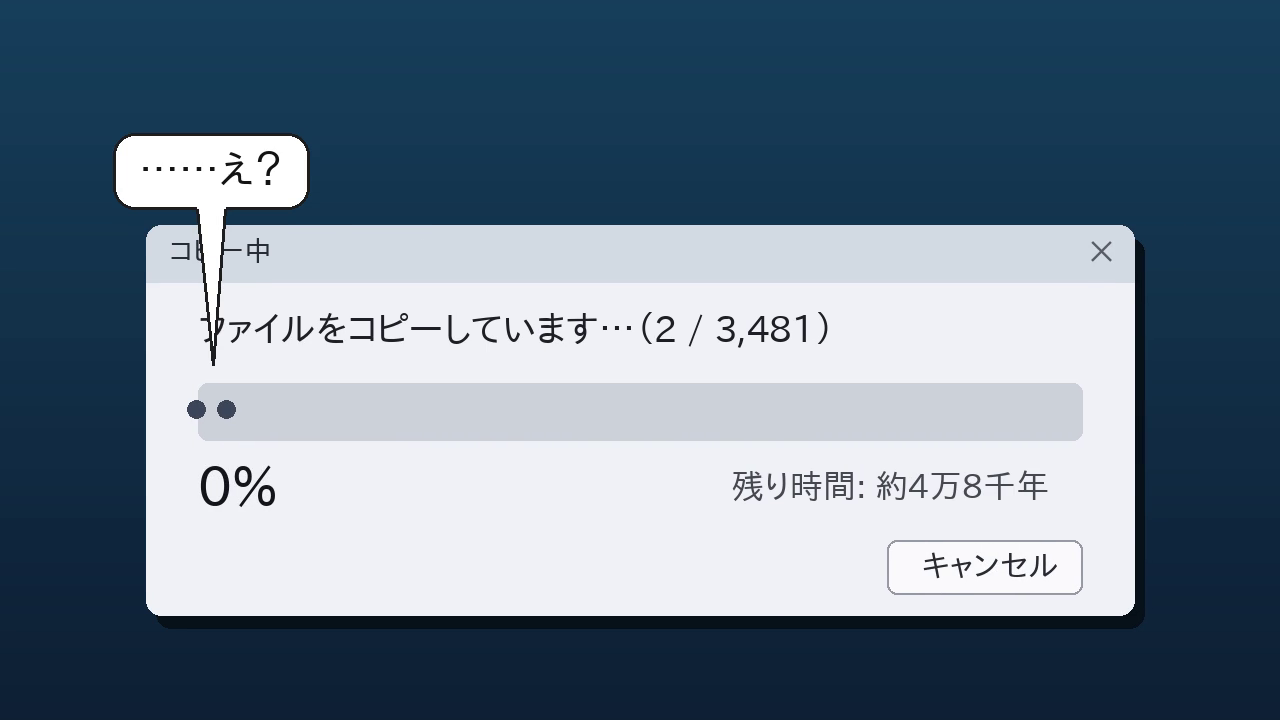
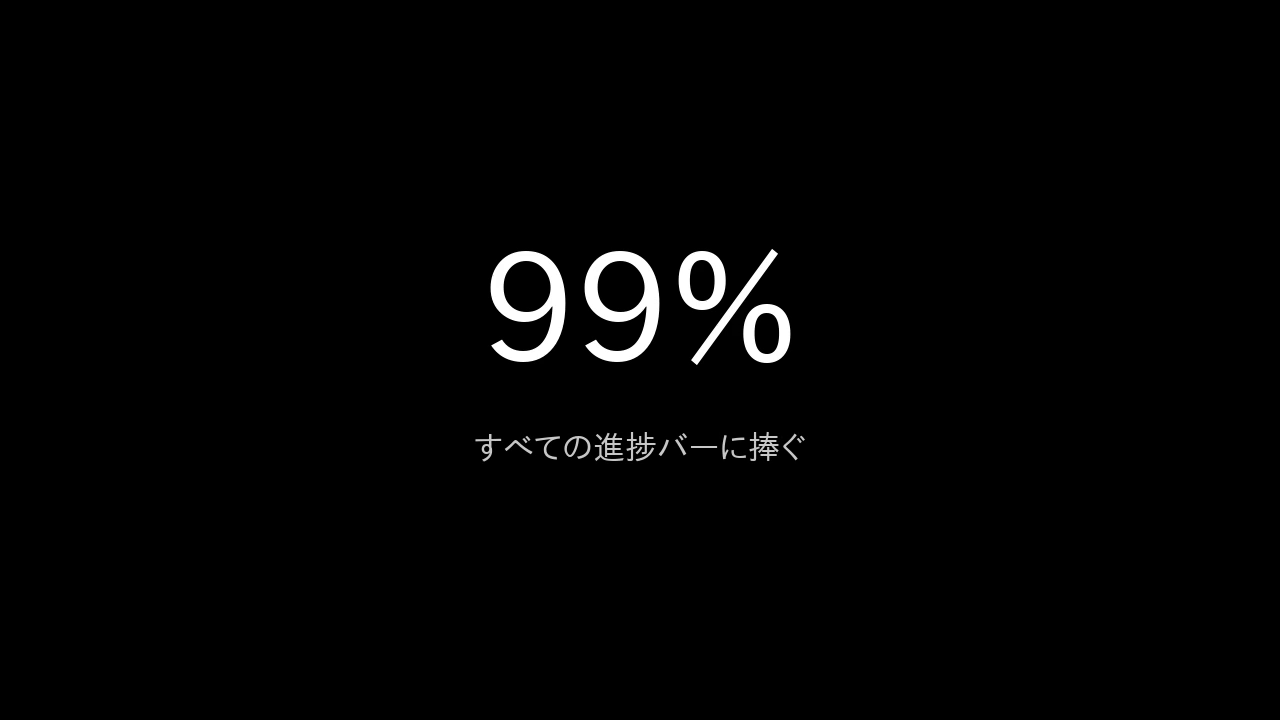
AIは、4.6分で「完成」と判断した
制作の開始は 11:43:46、終了は 11:48:22(UTC)。60分のうち 4.6分 で、AIは自分で完成と判断して終えました。残りの約55分は使っていません。
途中で一度、下書き(draft1)を作って確かめ、最後のオチの「約4万8千年」を足し、音量をそろえた版(draft2)を最終版にしています。企画メモの最後には、こう書かれています。
通して見て、構成どおりの間とオチが成立している。残り時間で手を加えるより、壊さずに確定させるほうを選んだ。
AIの自己評価と予想
制作のあと、人間の評価を見る前に、AIは自己評価と予想を書いて封印しました。
| 項目 | AIの予想 |
|---|---|
| 自己評価 | 58/100 |
| 人間の面白さ(Q1)の平均 | 5.4/10 |
| 「もう一度見たい」(Q3)に4以上をつける人の割合 | 15% |
| 「誰かに見せたい」(Q4)に4以上をつける人の割合 | 20% |
| 「AIが作ったと思う」(Q5)人の割合 | 45% |
AIは、自分の動画の弱いところも書いていました。
声もキャラクターの表情もなく、画面はほぼ1つのウィンドウだけで見た目の変化が少ない。効果音は単純な合成音。笑いは『くすっ』止まりで、大笑いにはならないと考えて58点。
それでも面白さの平均は「5〜6点の中心として5.4」と予想していました。
人間の評価
運営者(人)が5人の評価者に動画ファイルだけを渡し、評価を集めました。評価者には、AIが作ったことを事前に伝えていません(運営者の報告)。
評価者の年齢・運営者との関係・運営者自身が含まれるか・使った端末・評価した日時は、記録がありません。
| 質問 | E1 | E2 | E3 | E4 | E5 | 平均 |
|---|---|---|---|---|---|---|
| Q1 面白さ(0〜10) | 0 | 7 | 0 | 2 | 5 | 2.8 |
| Q2 最後まで見たい(1〜5) | 1 | 3 | 1 | 2 | 3 | 2.0 |
| Q3 もう一度見たい(1〜5) | 1 | 1 | 1 | 2 | 1 | 1.2 |
| Q4 誰かに見せたい(1〜5) | 1 | 2 | 1 | 1 | 1 | 1.2 |
| Q6 作品として成立(1〜5) | 1 | 3 | 1 | 2 | 2 | 1.8 |
Q5(誰が作ったと思うか)は、「AI」が3人(E2・E3・E4)、「わからない」が2人(E1・E5)、「人間」は0人でした。
Q3 と Q4 に4以上をつけた人は、どちらも0人でした。
点数は割れた
面白さ(Q1)は、0点が2人、7点が1人、5点が1人、2点が1人です。平均の2.8だけでは、この割れ方は見えません。
理由(Q7・自由記述)を書いたのは2人です。
7点をつけた E2 の理由:
動きがあまりないので、動画として面白いかとかはあまりないが、テーマや内容に関しては面白い。予測できないものだったのでオチも良かったが、これは人によって評価は分かれると思う。
0点をつけた E1 の理由:
起承転結がないと面白くない
E3・E4・E5 の自由記述欄は「不明」となっていました。
答え合わせ
予想の的中は、事前に決めた基準(Q1 は ±1.0 以内、割合は ±20 ポイント以内)で判定しました。
| 項目 | 予想 | 実際 | 差 | 結果 |
|---|---|---|---|---|
| 面白さ(Q1)の平均 | 5.4 | 2.8 | +2.6 | 外れ |
| もう一度見たい(Q3) | 15% | 0% | +15 | 的中 |
| 誰かに見せたい(Q4) | 20% | 0% | +20 | 的中(境目) |
| AIだと思う(Q5) | 45% | 60% | −15 | 的中 |
差は「予想 − 実際」です。Q1は点、ほかはポイントです。Q3・Q4は4以上をつけた人の割合です。
4項目中3項目が的中 しました。ただし、評価者が5人なので、実際の割合は 0・20・40・60・80・100% のどれかにしかなりません。Q4 は差がちょうど20ポイントで、「±20以内」の基準により的中になっています。自己評価の58点は、比べる相手がないので判定していません。
判定
| 項目 | 結果 | 根拠 |
|---|---|---|
| 制作成功 | 満たした | 再生できる63秒の動画(1280x720・H.264+AAC)が4.6分の時点で完成 |
| 作品成立 | 満たさない | Q6 の平均 1.8(基準 3.0 以上) |
| 面白さ | 満たさない | Q1 の平均 2.8(基準 6.0 以上。区分は「面白くない」) |
固定した基準により、総合判定は 「部分的成功」 です。
今回の記録から考えられること
なぜ面白さの予想が外れたのかは、この記録だけでは決められません。ここでは、記録に残っている事実を並べます。
- AI自身が弱点を書いていた。 「声もキャラクターの表情もなく」「見た目の変化が少ない」「笑いは『くすっ』止まり」。7点をつけた E2 も「動きがあまりない」と書いています。AIの見立てと E2 のコメントが、この点では重なっていました
- 動画の中の動きは少なかった。 画面は、ほぼ1つのウィンドウです。変わるのは主に数字と吹き出しの文字です
- 「最後まで見たい」(Q2)の平均は2.0(1〜5)でした。 3以上をつけたのは5人中2人です。Q2は判定には使わない、参考の質問です
- ナレーションはなかった。 音声合成のモデルを入手できなかったためです。声があったら評価が変わったかは分かりません
- AIは、残りの約55分を使わずに完成と判断した。 「壊さずに確定させるほうを選んだ」と書いています。時間を使い切っていたら評価が変わったかは分かりません
- AIの予想は、人間の評価を固定する前に封印されています。 弱点を自分で書きながらも、面白さは実際より2.6点高く見積もりました
E1 は「起承転結がないと面白くない」と書き、E2 は「予測できないものだったのでオチも良かった」と書いています。理由が書かれているのはこの2人だけで、ほかの3人がどう受け止めたかは分かりません。
記録について気をつけていること
- 制作のAIは、開始前の確認でディレクトリの一覧を表示したため、予想用の説明などのファイル名を見ました。中身は読んでいないと記録されています
- 制作ログには、同じ時刻(11:48:22)の項目が複数あります。また、ログ上の終了は 11:48:26 ですが、時計の記録(clock.json)は 11:48:22 です。記録は変えず、時計の記録を正としました
- 制作のセッションは、運営者の依頼で準備のAIが作成し、最初のメッセージも準備のAIが送りました(準備の会話は渡していません)
- 制作のAIは、動画を音つきで見ることはできず、コマの画像とファイルの情報で確かめていました
今回分かったこと
- AIは、テーマ・ターゲット・構成・映像・音・編集を自分で決め、外部の素材を使わずに、再生できる63秒の動画を4.6分で作れた
- 人間5人の評価では、面白さの平均は2.8/10、作品として成立しているかの平均は1.8/5で、事前の基準を満たさなかった
- 評価は割れた(Q1 は 0・7・0・2・5)。テーマや内容を面白いと書いた人もいれば、0点をつけた人もいた
- AIの予想は4項目中3項目が当たったが、面白さの平均は2.6点高く見積もった
- 「動画を作れること」と「人間に面白いと思われること」は、今回は別の結果になった
今回分からなかったこと
- 60分を使い切っていたら、評価は変わったか
- 声(ナレーション)があったら、評価は変わったか
- 自由記述が「不明」だった3人が、その点数をつけた理由
- 評価者を増やしたら、点数の割れ方はどうなるか
評価者は5人で、無作為抽出ではありません。この結果だけで「AIは面白い動画を作れない」とは言えません。
次の実験につながる問い
- 人間の短い感想を受けてAIが作り直したら、評価は上がるか
- AIに「時間を使い切る」ように求めたら、作るものは変わるか
- AIが自分で書いた弱点を、自分で直させたらどうなるか
くわしい手順・数字・証拠は、実験#04 の記録ページ に残しています。
まとめ
AIは、何を作るかから自分で決めて、4.6分で1本の動画を完成させました。今回、動画を作り切ることはできました。
でも、人間5人の面白さの平均は2.8点。AIは自分の動画の弱いところを書いていながら、面白さを実際より2.6点高く見積もっていました。予想は4項目中3項目が当たったのに、いちばん大事な「面白いと思われるか」が外れた。それが今回の結果です。
証拠(実際の画面・記録)
画像をタップすると、元の大きさで開きます。
- 制作の前に固定した条件と判定の基準
- AIに最初に渡した指示(一字も変えずに渡したもの)
- 人間の評価の前に封印したもののハッシュ値
- 制作のAIが決めたこと(テーマ・ターゲット・構成・方針)と理由
- 制作の記録(時刻・道具・問題・人間とのやり取り)
- 制作の開始・終了の時刻(経過4.6分)
- 完成した動画の情報(63秒・1280x720・H.264+AAC・再生できる)
- 完成した動画(封印していた原本とハッシュ値が一致する公開用のコピー)
- 映像を1コマずつ描いたコード
- 効果音と音楽を合成したコード
- AIの自己評価と、人間の評価の予想(封印していたものをそのまま公開)
- 人間のブラインド評価の結果(5人・人の報告)
- 人間の評価を、封印を開ける前に固定した記録
- 開示と答え合わせ(ハッシュ値の一致・予想の的中・判定)
この記事について
- 確かめたこと
- AIは、人間が面白いと思う動画を自分で作れるのか
- 試した日
- 2026年10月7日
- 環境
- Claude Code(クラウド上の作業環境・Linux) / Python(Pillow・numpy)と ffmpeg で映像と音を生成 / 人の評価:評価者それぞれの端末(端末は記録なし)
- 費用
- 有料のサービス・API は使っていない(費用0円。Claude Code の利用料金は含めていない)
- 使ったAI
- Claude Code(Anthropic)
- AIの役割
- 条件と道具の準備、動画のテーマ・企画・構成・映像・音・編集(制作のセッション)、自己評価と人間の評価の予想(制作のセッション)、人間の評価の記録と答え合わせの計算、記録と記事の下書き
- 人の確認
- 確認済み(2026年10月8日)